

Bạn mở Ollama, gõ câu hỏi, đợi vài giây mới thấy chữ đầu tiên, rồi sau đó văn bản lại chạy rất nhanh. Token/s là số token, tức mẩu chữ nhỏ mà mô hình xử lý, được sinh ra trong một giây khi AI chạy ngay trên laptop thay vì trên máy chủ. Token mỗi giây chỉ mô tả một phần của trải nghiệm đó, phần còn lại nằm ở độ trễ token đầu, thời gian nạp model và cách laptop phân chia công việc giữa CPU với GPU. Tôi tách từng con số theo tài liệu chính thức của Ollama, llama.cpp và LM Studio để bạn đọc đúng tốc độ token trên chính laptop đang dùng.
Token mỗi giây thực chất gồm hai giai đoạn đo khác nhau
Token là đơn vị văn bản do bộ tách từ của mô hình tạo ra, có thể là một từ, một phần của từ hoặc dấu câu. Mỗi câu hỏi đi qua hai giai đoạn liên tiếp. Giai đoạn đầu gọi là prefill, mô hình đọc toàn bộ prompt để tính các trạng thái trung gian rồi sinh ra token đầu tiên. Giai đoạn sau gọi là decode, mô hình sinh lần lượt từng token cho tới khi gặp điều kiện dừng. Theo blog kỹ thuật của NVIDIA về tối ưu suy luận, prefill là phép nhân ma trận có mức song song hóa cao, tận dụng gần hết năng lực GPU.
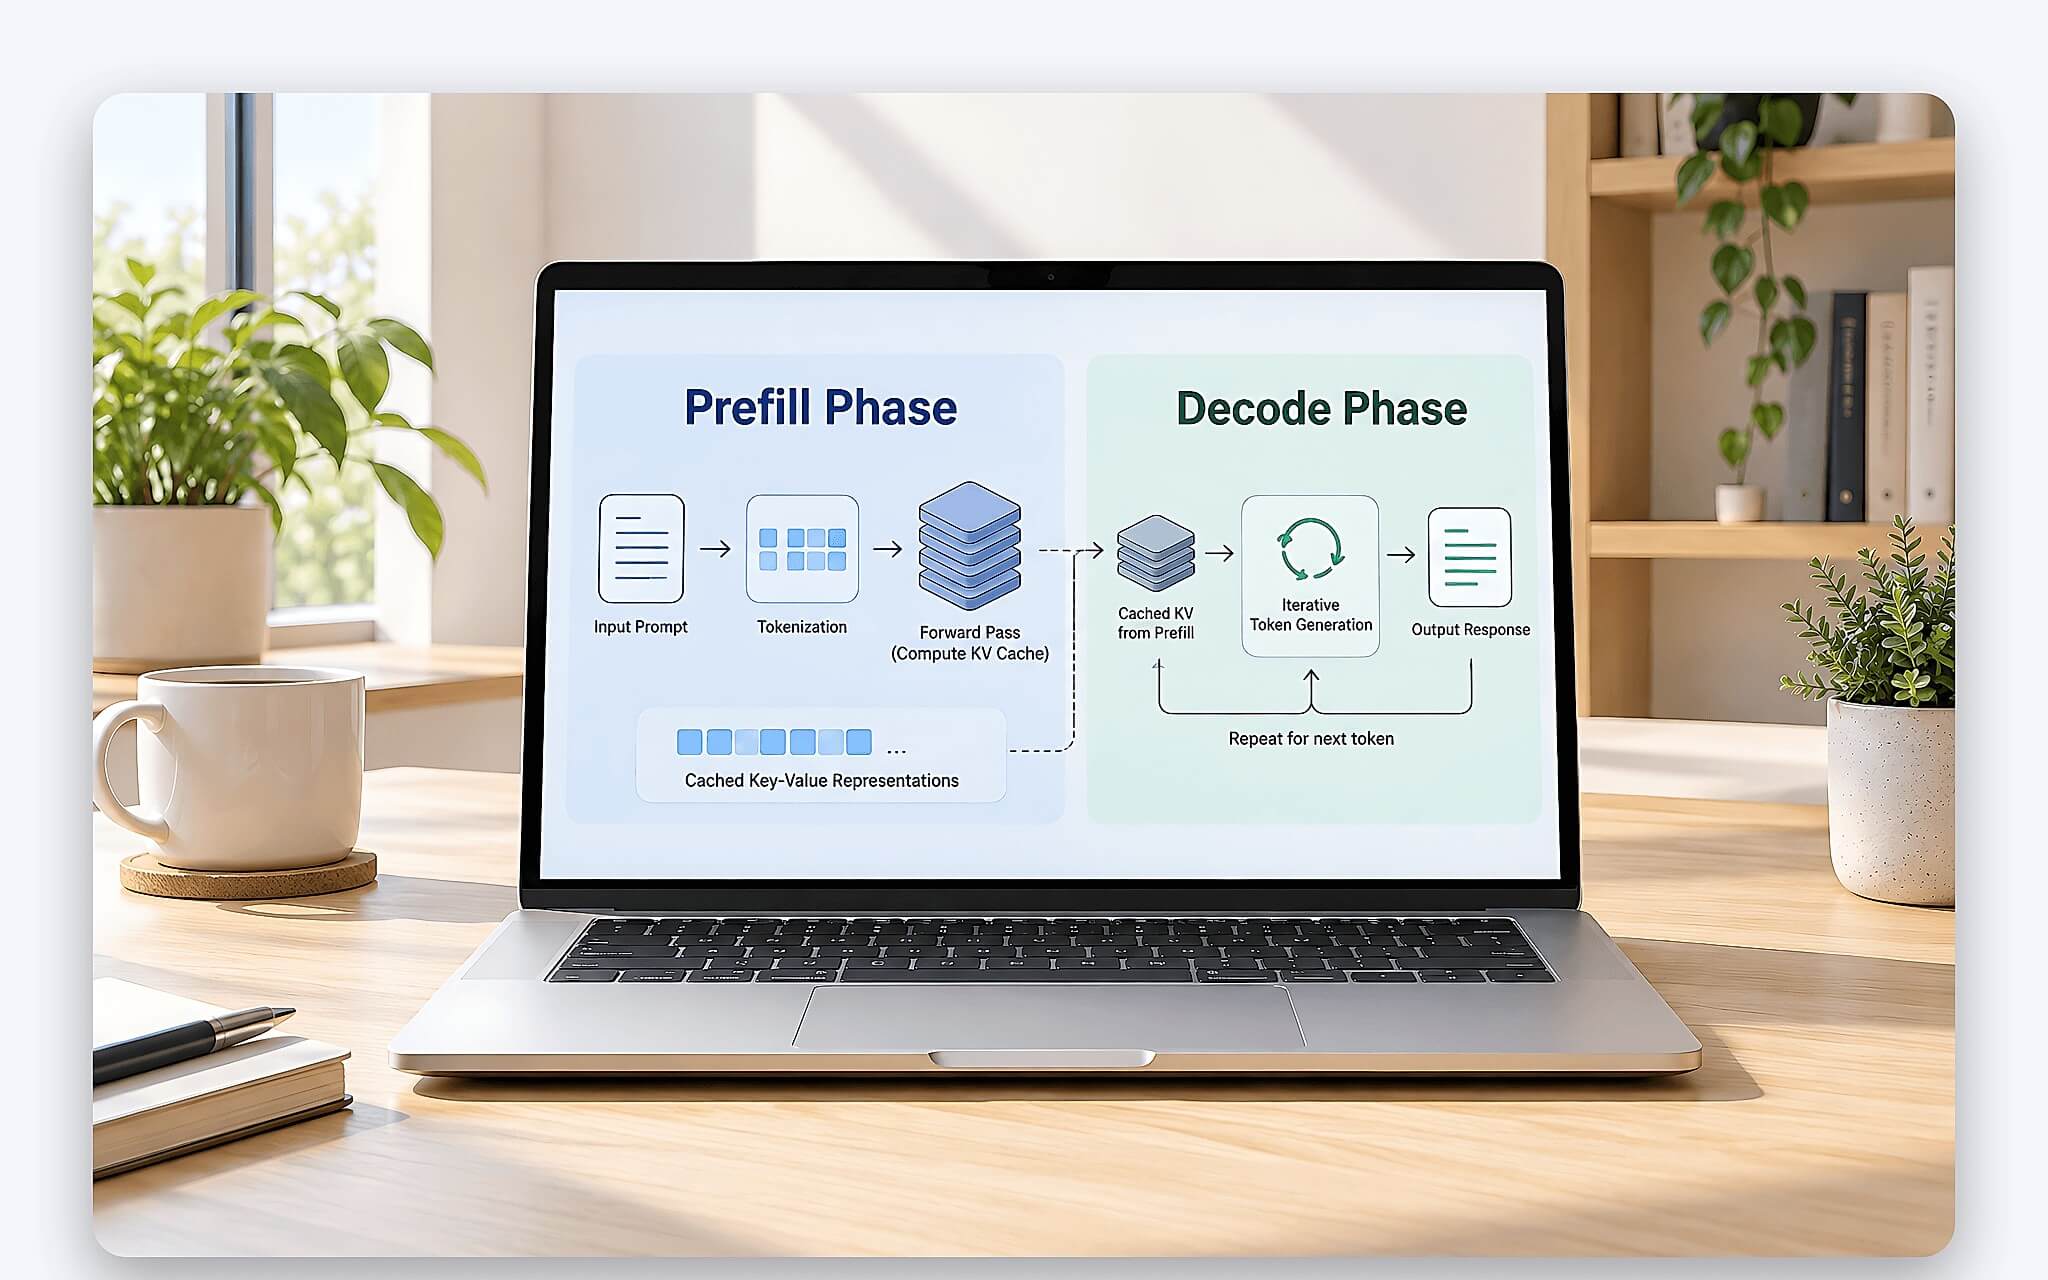
Vì hai giai đoạn có bản chất khác nhau, các công cụ nghiêm túc đều báo hai con số Token mỗi giây riêng biệt. Ollama gọi chúng là prompt eval rate và eval rate. llama.cpp dùng ký hiệu pp cho xử lý prompt và tg cho sinh văn bản. Trong các ví dụ của chính tài liệu llama-bench, con số pp đều cao hơn tg trên cùng cấu hình, ở ví dụ chạy hoàn toàn trên GPU chênh tới khoảng 18 lần. Đem con số prefill ra mô tả tốc độ trả lời vì thế là cách đọc sai phổ biến nhất mà tôi gặp.
Tầng thứ ba là khoảng thời gian trước khi mọi thứ bắt đầu, tức lúc nạp trọng số model từ SSD vào RAM hoặc VRAM. Khoảng này không thuộc prefill hay decode nhưng ảnh hưởng đáng kể tới thời gian chờ. Khi đánh giá tốc độ token của một laptop, tôi luôn ưu tiên ghi đủ ba phần gồm thời gian nạp, tốc độ xử lý prompt và tốc độ sinh. Thiếu một phần, kết luận rất dễ lệch.
Độ trễ token đầu tăng theo độ dài prompt và ngữ cảnh
Tài liệu chỉ số đo hiệu năng mô hình ngôn ngữ của NVIDIA định nghĩa TTFT, tức độ trễ token đầu, là khoảng thời gian từ lúc gửi yêu cầu tới khi nhận được token đầu tiên. Khoảng này gồm thời gian xếp hàng, thời gian prefill và độ trễ mạng. Trên laptop chạy cục bộ, độ trễ mạng gần như bằng không, nên phần lớn độ trễ token đầu đến từ prefill, cộng thêm thời gian nạp nếu model chưa nằm sẵn trong bộ nhớ.
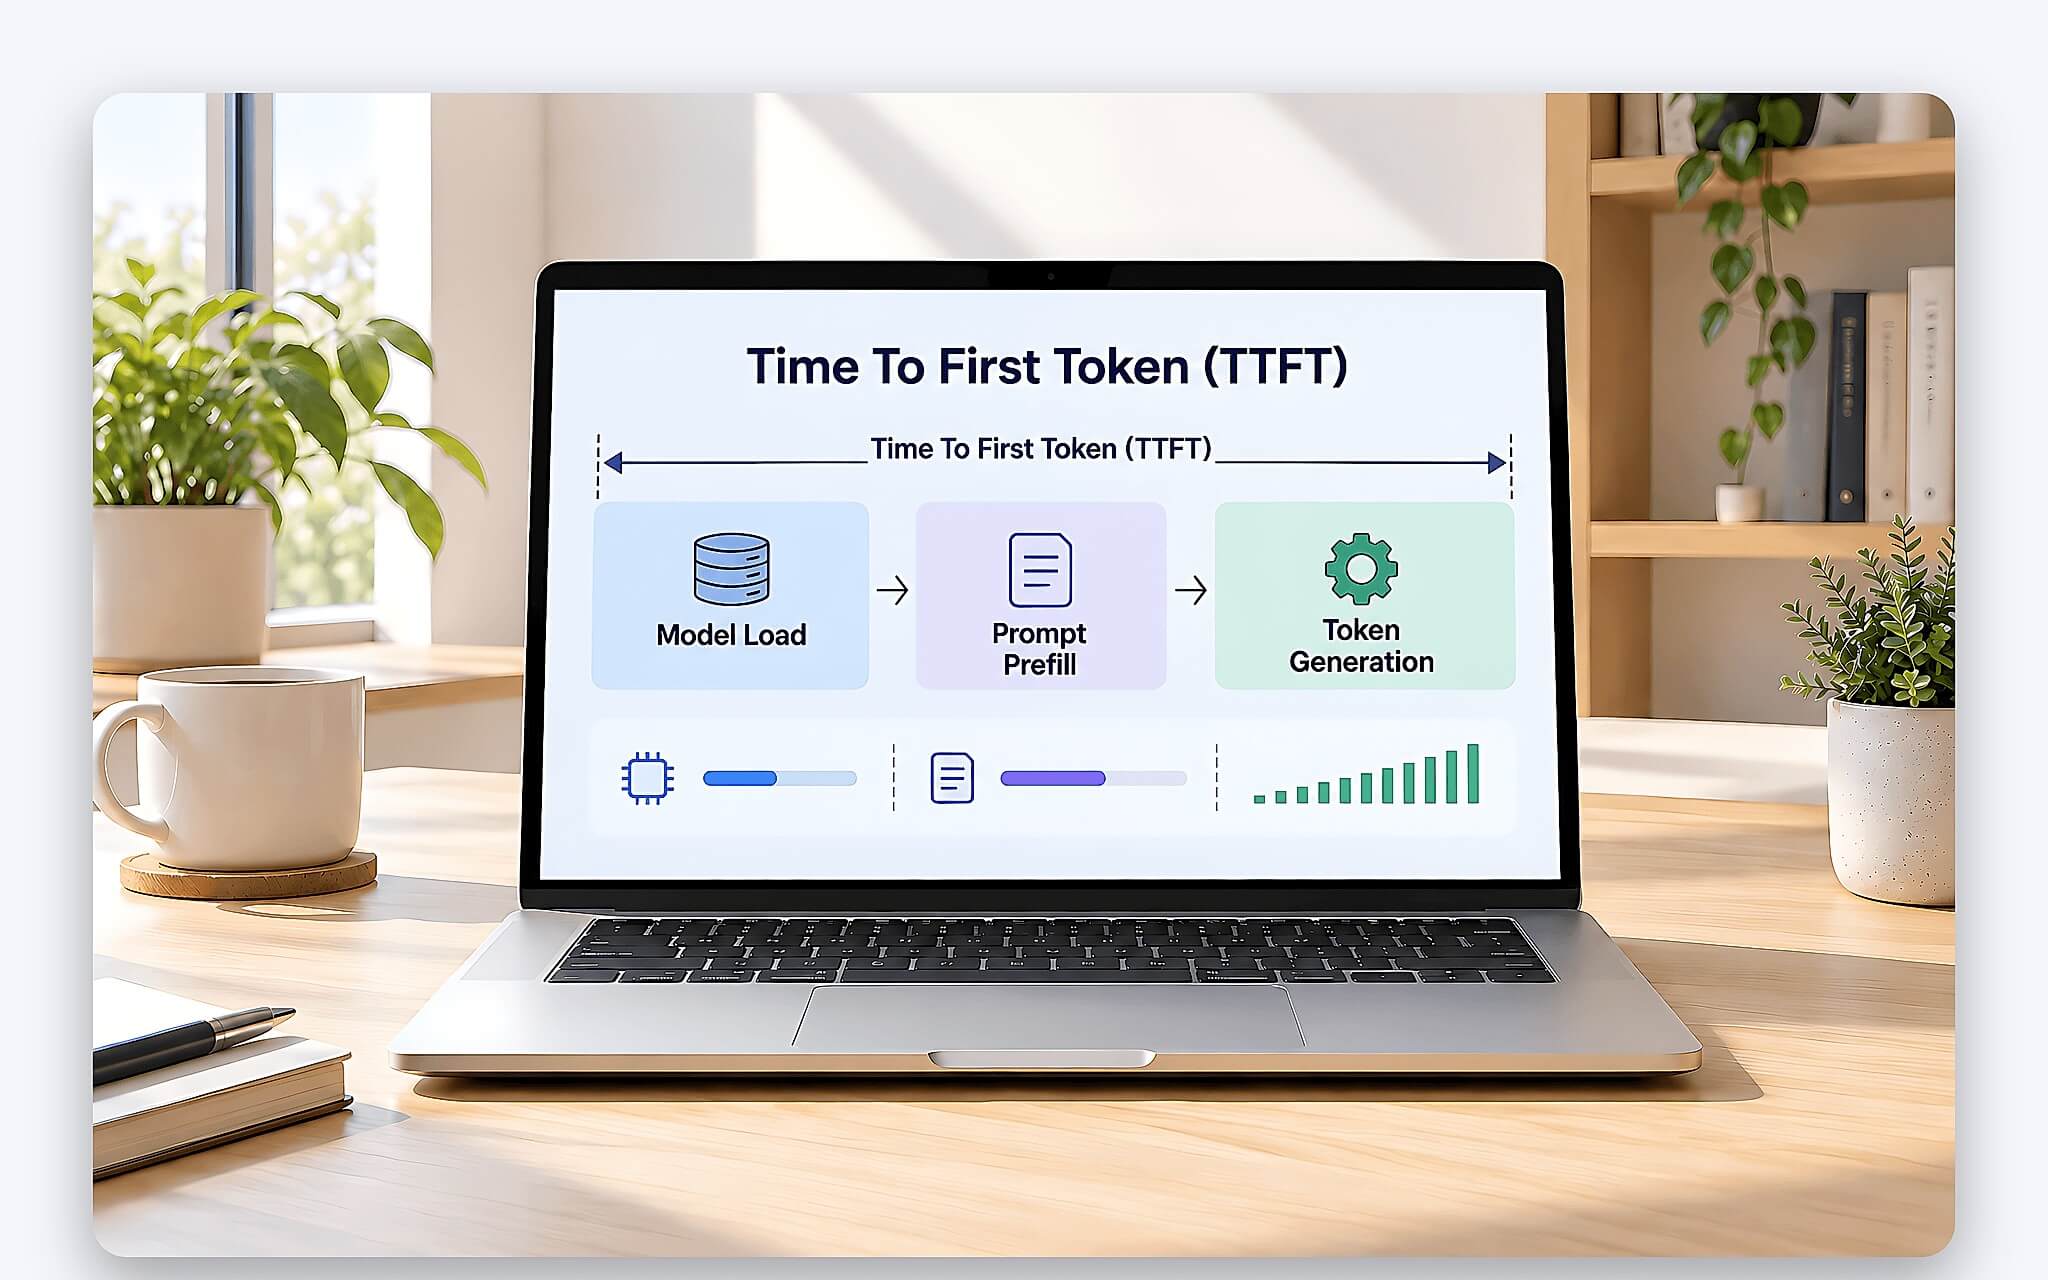
Thời gian prefill tăng theo số token đầu vào. Trong ví dụ phản hồi mẫu của tài liệu API Ollama, prompt 26 token chỉ mất khoảng 0,13 giây để xử lý. Khi bạn dán cả một tài liệu dài hoặc trò chuyện qua nhiều lượt, khối lượng cần xử lý tăng lên đáng kể. Tài liệu API của LM Studio ghi rõ số token đầu vào bao gồm phần định dạng, định nghĩa công cụ và các tin nhắn trước đó trong cuộc trò chuyện. Vì vậy độ trễ token đầu có thể tăng dần theo độ dài phiên chat dù câu hỏi mới rất ngắn.
Đây là lý do chữ có thể chạy nhanh mà phản hồi vẫn chậm. Tốc độ sinh cao chỉ cải thiện phần sau token đầu, còn độ trễ token đầu quyết định bạn ngồi chờ bao lâu trước khi thấy bất cứ chữ nào. Với trợ lý lập trình chạy cục bộ, mỗi lần gợi ý lại kèm theo đoạn mã xung quanh, nên ngưỡng độ trễ chấp nhận được khắt khe hơn hẳn trò chuyện thông thường, điều tôi đã phân tích trong bài Trợ lý code offline: Laptop AI cần gì để phản hồi mượt trong IDE?
Cách đọc từng dòng thống kê khi chạy Ollama ở chế độ verbose
Ollama in bảng thống kê sau mỗi câu trả lời khi bạn chạy lệnh ollama run kèm cờ --verbose. Mã nguồn Ollama cho thấy các dòng lần lượt là total duration, load duration, prompt eval count, prompt eval duration, prompt eval rate, eval count, eval duration và eval rate. Nếu một phần prompt được lấy lại từ bộ đệm, Ollama in thêm dòng prompt eval cached. Bảng dưới gom các dòng này theo đúng giai đoạn mà chúng đo.
| Dòng thống kê | Ý nghĩa | Giai đoạn |
|---|---|---|
| total duration | Tổng thời gian xử lý yêu cầu | Toàn bộ |
| load duration | Thời gian nạp model vào bộ nhớ | Trước prefill |
| prompt eval count | Số token trong prompt | Prefill |
| prompt eval duration | Thời gian xử lý phần prompt chưa có trong bộ đệm | Prefill |
| prompt eval rate | Số token prompt chưa đệm chia cho thời gian xử lý | Prefill |
| eval count | Số token trong câu trả lời | Decode |
| eval duration | Thời gian sinh câu trả lời | Decode |
| eval rate | eval count chia cho eval duration | Decode |
Con số cần nhìn khi bạn hỏi về tốc độ token lúc chữ đang chạy là eval rate. Tài liệu API gốc của Ollama ghi mọi khoảng thời gian tính bằng nano giây và hướng dẫn tính Token mỗi giây của câu trả lời bằng eval_count chia eval_duration rồi nhân 10^9. Phản hồi mẫu trong tài liệu có eval_count 259 và eval_duration khoảng 4,23 giây, tương đương xấp xỉ 61 token mỗi giây. Bạn có thể tự xác minh định nghĩa từng trường trong tài liệu API generate trên trang docs.ollama.com.
Ví dụ đó còn bộc lộ một điểm dễ bỏ qua. Tổng thời gian là 10,7 giây nhưng load duration đã chiếm khoảng 6,3 giây, prompt eval chỉ khoảng 0,13 giây cho 26 token và phần sinh 259 token mất 4,23 giây. Nghĩa là gần 60% thời gian chờ nằm ở khâu nạp model. Nếu chỉ nhìn tốc độ token của eval rate quanh 61 tok/s, bạn sẽ không hiểu vì sao lần hỏi đầu tiên lại lâu như vậy, còn các lần hỏi ngay sau đó lại phản hồi gần như tức thì.
Đọc pp và tg trong llama-bench cùng thống kê của LM Studio
llama-bench là công cụ đo hiệu năng đi kèm llama.cpp. README của công cụ nêu ba kiểu thử. pp là xử lý prompt theo lô, đặt bằng tham số -p với mặc định 512 token. tg là sinh chuỗi token, đặt bằng -n với mặc định 128 token. pg là xử lý prompt rồi sinh tiếp. Mỗi phép thử lặp lại 5 lần theo mặc định, kết quả là Token mỗi giây trung bình kèm độ lệch chuẩn và không gồm thời gian tách từ hay lấy mẫu.
| Số luồng CPU | pp 64 (t/s) | tg 16 (t/s) |
|---|---|---|
| 1 | 6,17 | 4,05 |
| 2 | 12,31 | 7,80 |
| 4 | 23,18 | 12,22 |
| 8 | 32,29 | 16,71 |
| 16 | 33,52 | 15,32 |
| 32 | 59,00 | 16,41 |
Bảng trên là ví dụ chạy thuần CPU trong README llama-bench với model Llama 7B Q4_0 dung lượng 3,56 GiB. README không ghi tên bộ xử lý nên tôi chỉ đọc xu hướng. pp tăng gần mười lần khi đi từ 1 lên 32 luồng, còn tốc độ token ở bài tg dừng quanh 15 đến 17 t/s từ 8 luồng trở lên. Thêm nhân tính toán giúp prefill nhưng gần như không giúp decode, dấu hiệu cho thấy decode bị giới hạn ở chỗ khác. Với tham số -d, README ghi pp512 của Qwen2 7B giảm từ 7.340 xuống 6.426 t/s khi bộ đệm ngữ cảnh đã chứa sẵn 512 token.
Với LM Studio, tài liệu REST API mô tả phần thống kê của mỗi phản hồi gồm input_tokens, total_output_tokens, tokens_per_second là tốc độ sinh, time_to_first_token_seconds là thời gian tạo token đầu tiên và model_load_time_seconds. Trường cuối chỉ xuất hiện khi model chưa được nạp sẵn. Như vậy tokens_per_second của LM Studio tương ứng eval rate của Ollama và tg của llama-bench, còn time_to_first_token_seconds phản ánh độ trễ token đầu. Khi ai đó gửi bạn ảnh chụp kết quả, hãy hỏi rõ con số tốc độ token đó thuộc trường nào.
Băng thông bộ nhớ quyết định tốc độ token khi sinh chữ
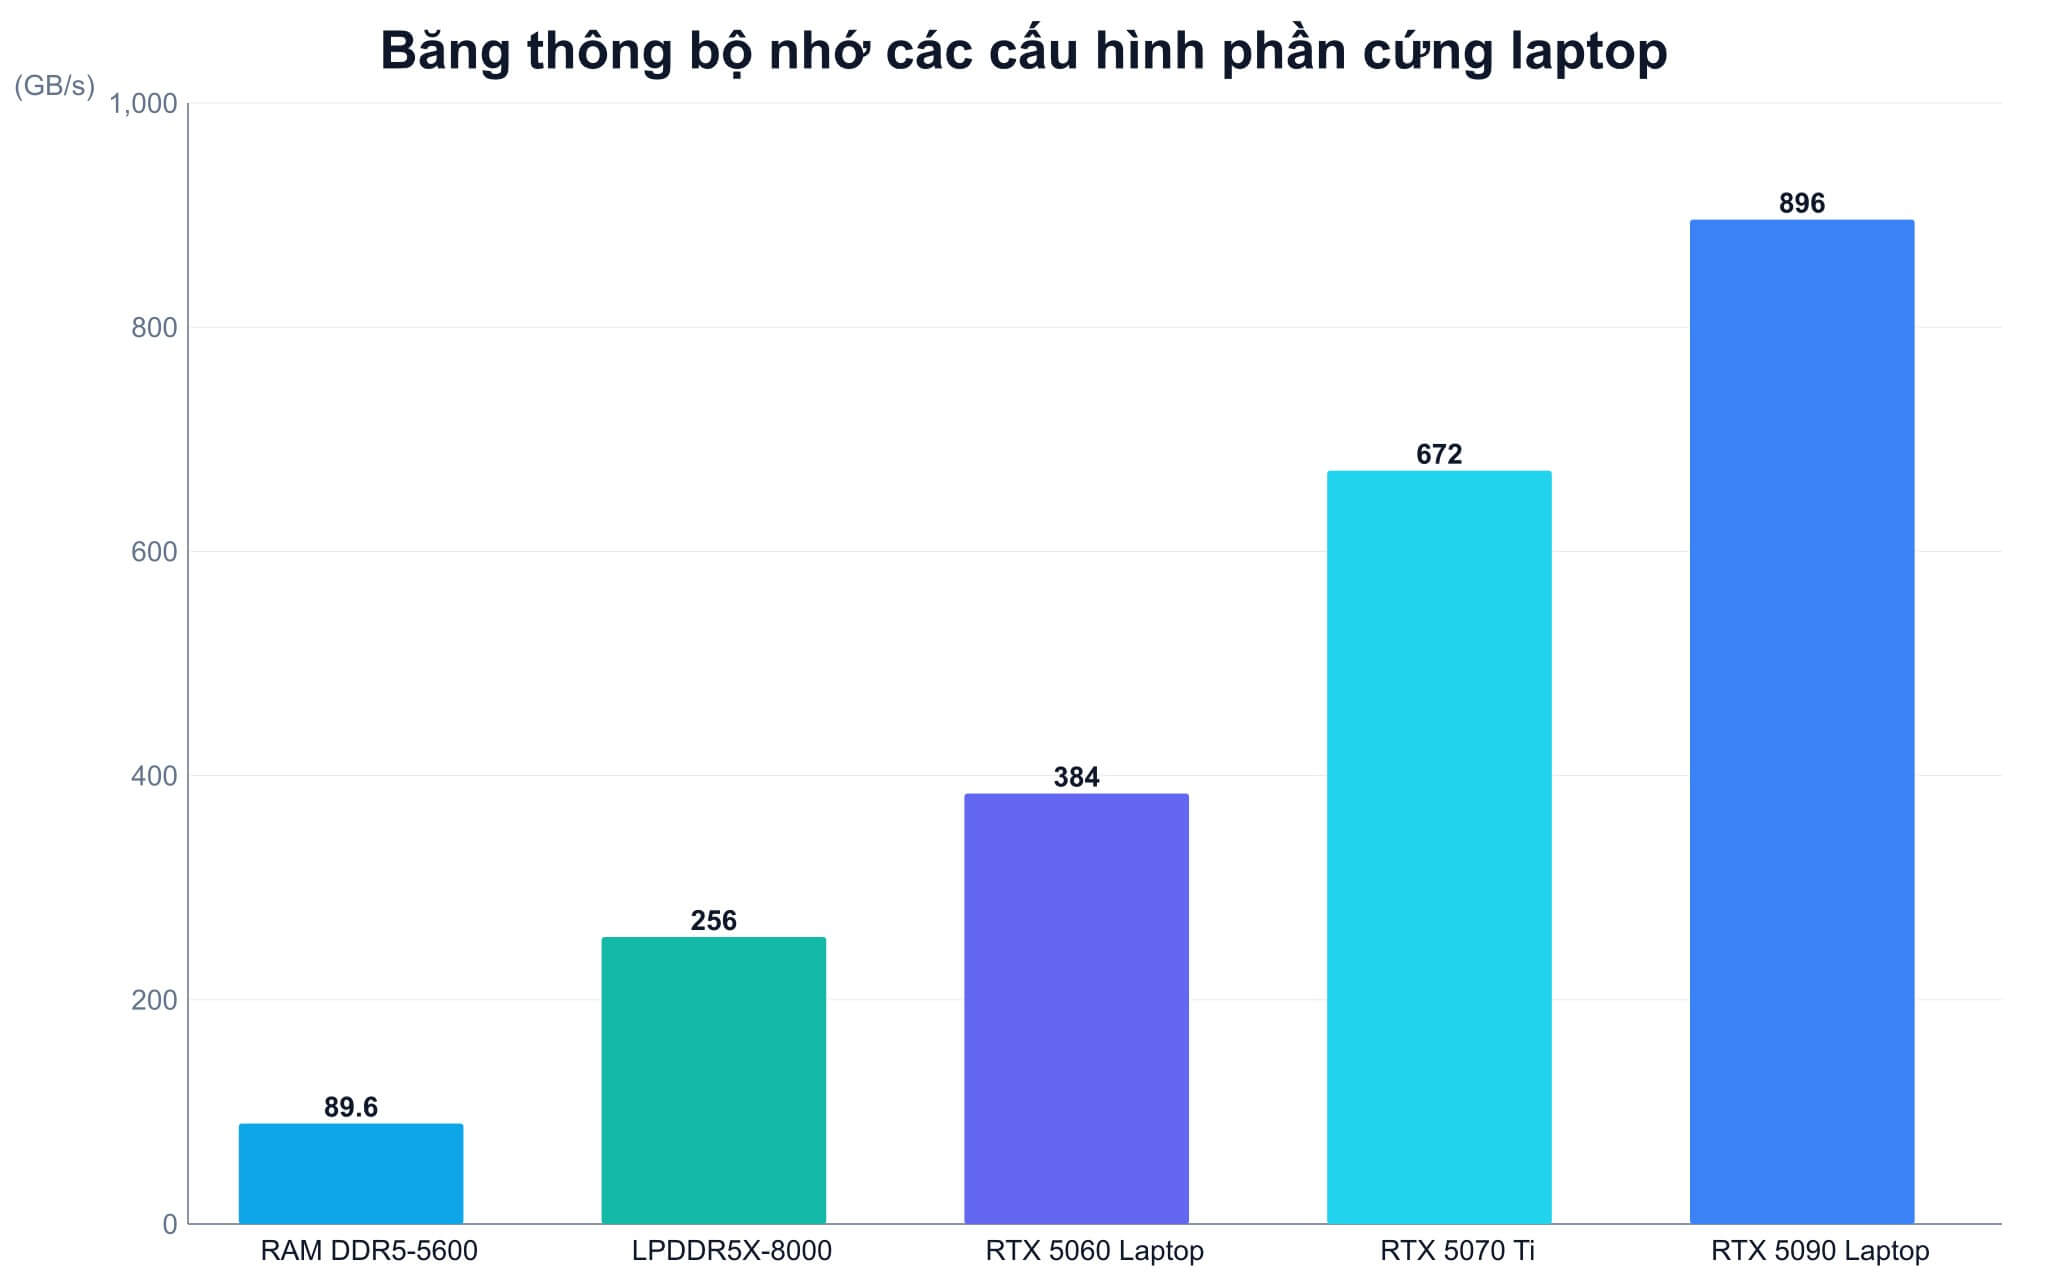
Theo blog kỹ thuật NVIDIA về tối ưu suy luận mô hình ngôn ngữ, ở giai đoạn decode, tốc độ chuyển dữ liệu gồm trọng số, key, value và activation từ bộ nhớ lên GPU chi phối độ trễ, không phải tốc độ tính toán. Bài viết xếp đây vào nhóm thao tác bị giới hạn bởi bộ nhớ, cụ thể là băng thông đọc trọng số. Mỗi token mới đòi hỏi đọc lại phần lớn trọng số model, nên băng thông bộ nhớ đặt giới hạn trên cho Token mỗi giây ở giai đoạn sinh chữ.
| Bộ nhớ trên laptop | Băng thông (GB/s) | Nguồn số liệu |
|---|---|---|
| RAM DDR5-5600 hai kênh (128-bit) | 89,6 | Tính từ 5.600 MT/s nhân 16 byte |
| LPDDR5X-8000 256-bit (Ryzen AI Max+ 395) | 256 | Tính từ thông số bus và tốc độ AMD công bố |
| GDDR7 trên RTX 5060 Laptop GPU | 384 | NVIDIA |
| GDDR7 trên RTX 5070 Ti Laptop GPU | 672 | NVIDIA |
| GDDR7 trên RTX 5090 Laptop GPU | 896 | NVIDIA |
Từ nguyên lý đó có một phép ước lượng thô mà tôi hay dùng, lấy băng thông chia cho dung lượng model đã lượng tử để ra giới hạn trên lý thuyết. Model 4 GB nằm trọn trong VRAM của GPU 384 GB/s có giới hạn khoảng 96 token mỗi giây, còn khi chạy trên RAM DDR5-5600 hai kênh 89,6 GB/s chỉ quanh 22 token mỗi giây. Kết quả đo luôn thấp hơn vì còn phải đọc bộ đệm ngữ cảnh và chịu chi phí phần mềm, nên phép tính này chỉ dùng để so sánh chênh lệch tương đối giữa các cấu hình.
Điều này giải thích vì sao TOPS của NPU hay số nhân CUDA không đủ để dự đoán tốc độ token khi trò chuyện. Model chạy trên iGPU hoặc CPU dùng chung RAM hệ thống, nên chịu đúng giới hạn băng thông của RAM, nội dung được phân tích trong bài RAM CXMT DDR5 16GB: Băng thông cao đổi lấy hiệu năng gì? Prefill thì ngược lại, nghiêng về sức tính toán, nên GPU có ưu thế tính toán rút ngắn độ trễ token đầu rõ hơn khi bạn dán tài liệu dài vào khung chat.
Nạp model và chia lớp sang CPU làm phản hồi chậm ra sao
Theo FAQ chính thức, Ollama mặc định giữ model trong bộ nhớ 5 phút sau mỗi yêu cầu rồi mới giải phóng. Quá khoảng đó, lần hỏi kế tiếp phải nạp lại từ đầu và load duration lại cộng vào độ trễ token đầu. Bạn có thể đổi thời hạn này bằng tham số keep_alive trong API hoặc biến môi trường OLLAMA_KEEP_ALIVE. Đặt giá trị -1 sẽ duy trì model trong bộ nhớ vô thời hạn, đổi lại VRAM luôn bị chiếm một phần dung lượng.
Khi model cộng bộ đệm ngữ cảnh vượt quá VRAM, phần mềm sẽ chia một số lớp sang CPU và RAM hệ thống, kéo tốc độ token xuống rõ rệt. Lệnh ollama ps hiển thị cột PROCESSOR với các giá trị như 100% GPU, 100% CPU hoặc 48%/52% CPU/GPU cho trường hợp chia đôi. Tài liệu độ dài ngữ cảnh của Ollama khuyên tránh đẩy model sang CPU để đạt hiệu năng tốt nhất và cho biết ngữ cảnh mặc định phụ thuộc VRAM, dưới 24 GiB là 4k, từ 24 đến 48 GiB là 32k, từ 48 GiB trở lên là 256k token.
Ví dụ trong README llama-bench cho thấy cái giá của việc chia lớp. Cùng model 7B Q4_0, Token mỗi giây ở bài thử tg128 chỉ đạt 13,45 t/s khi đưa 10 lớp lên GPU, lên 40,04 t/s với 30 lớp và 131,66 t/s khi đưa 35 lớp. Laptop có GPU 6 đến 8 GB VRAM dễ rơi vào tình huống này khi dung lượng model vượt bộ nhớ đồ họa, như tôi đã trình bày trong bài Vì sao laptop chạy LLM trên GPU đời cũ đuối - Giới hạn VRAM và quá nhiệt
Câu hỏi thường gặp (FAQ)
Eval rate cao nhưng vẫn phải chờ lâu mới thấy chữ là do đâu?
Độ trễ token đầu gồm thời gian nạp model và prefill, không phụ thuộc eval rate. Bạn hãy xem load duration và prompt eval duration trong thống kê của Ollama. Nếu load duration lớn, model đã bị giải phóng sau thời hạn keep_alive. Nếu prompt eval duration lớn, lịch sử hội thoại hoặc tài liệu dán vào đang quá dài so với khả năng đáp ứng của laptop.
So sánh hai laptop chạy AI cục bộ nên dựa vào con số nào?
Hãy giữ nguyên model, mức lượng tử, độ dài ngữ cảnh và phiên bản phần mềm trên cả hai laptop. Với nhu cầu trò chuyện, tôi so Token mỗi giây ở giai đoạn sinh, tức tg hoặc eval rate. Với nhu cầu tóm tắt tài liệu dài, tôi so thêm pp hoặc prompt eval rate. llama-bench lặp lại mỗi phép thử 5 lần theo mặc định nên kết quả ổn định hơn một lần hỏi đáp thủ công. Bạn cũng nên cắm sạc và ghi lại chế độ điện năng khi đo, vì chế độ tiết kiệm điện có thể hạ xung nhịp.
NPU nhiều TOPS có giúp chữ hiện ra nhanh hơn không?
TOPS mô tả năng lực tính toán, trong khi giai đoạn decode chủ yếu bị giới hạn bởi băng thông bộ nhớ theo phân tích của NVIDIA. Một NPU nhiều TOPS dùng chung RAM hệ thống với CPU vẫn bị băng thông của RAM đó giới hạn tốc độ token. Sức tính toán cao có ích hơn ở giai đoạn prefill, tức phần rút ngắn thời gian chờ khi prompt dài, với điều kiện phần mềm hỗ trợ NPU.
Có quy đổi tok/s sang số chữ tiếng Việt mỗi giây được không?
Không có tỷ lệ cố định giữa Token mỗi giây và số chữ hiển thị. Mỗi model dùng một bộ tách từ riêng, nên cùng một câu tiếng Việt có thể thành số token khác nhau giữa hai model. Vì vậy tôi chỉ so tok/s giữa các phép đo dùng chung một model. Muốn biết trải nghiệm thực tế, bạn hãy chạy thử câu hỏi quen thuộc và quan sát cả thời gian chờ chữ đầu lẫn nhịp chữ chạy sau đó.
Để lại một bình luận